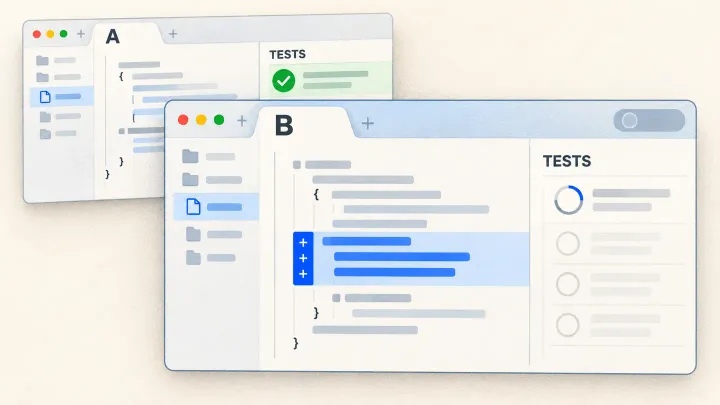
La version défectueuse a renvoyé deux dossiers :
a-complete
b-complete
La demande concernait l’entreprise A. Le deuxième dossier appartenait à l’entreprise B. Les trois tests ont tout de même réussi.
Il s’agit d’une démonstration volontairement construite et exécutable, pas d’un incident chez un client ni d’une évaluation d’un modèle d’IA. Son intérêt est de rendre un angle mort observable, plutôt que de vous demander de croire un récit.
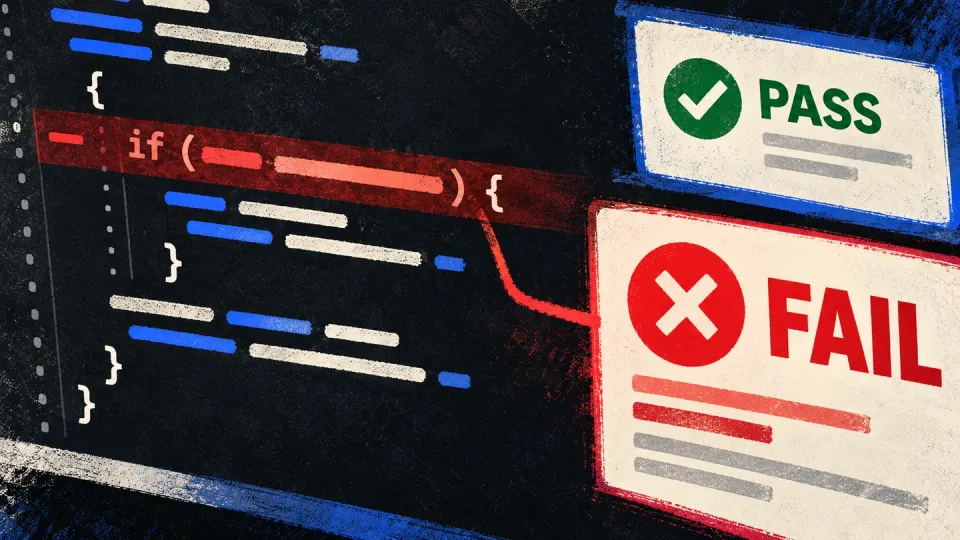
Les tests fonctionnaient. Ils ne vérifiaient pas le bon problème.
L’expérience contient trois dossiers fictifs : une intervention terminée pour l’entreprise A, une intervention encore ouverte pour A et une intervention terminée pour B. Le bon export doit contenir uniquement a-complete.
Les contrôles de départ vérifient que le résultat contient des lignes, que les colonnes sont les bonnes et que toutes les interventions retournées sont terminées. Ce sont des vérifications légitimes. Aucune ne porte sur l’entreprise à laquelle appartiennent les dossiers.
Voici la condition qui permet de produire les deux versions :
.filter((job) => removeCustomerBoundary || job.company === company)Lorsque removeCustomerBoundary vaut false, le filtre par entreprise s’applique. Lorsqu’il vaut true, toutes les interventions terminées passent. Le deuxième réglage supprime volontairement la séparation entre clients; ce n’est pas une solution proposée pour la production.
L’exécution a donné les résultats suivants :
| Version | Dossiers retournés | Tests de départ réussis | Contrôle des dossiers exacts |
|---|---|---|---|
| Filtre par entreprise présent | a-complete | 3 sur 3 | Réussi |
| Filtre par entreprise supprimé | a-complete, b-complete | 3 sur 3 | Échoué |
Les tests de départ n’étaient donc pas en panne. Les deux résultats satisfaisaient toutes leurs conditions. Leur réussite était réelle, mais elle ne répondait pas à la question décisive pour cette demande.
Une deuxième vérification doit pouvoir apporter autre chose
Supposons qu’on demande à une deuxième personne de confirmer la présence de lignes, les colonnes et le statut des interventions. La version défectueuse satisfait encore à cette description. Répéter un critère incomplet ne le rend pas complet.
Cette expérience ne fait intervenir aucun agent. Elle ne permet donc pas d’estimer la fréquence d’une telle erreur chez les agents IA. Elle montre plutôt une limite de la vérification : s’entendre sur ces trois propriétés ne permet pas d’établir que les dossiers des clients sont bien séparés.
Le contrôle supplémentaire compare les identifiants obtenus à un résultat attendu, défini séparément :
assert.deepEqual(rows.map((row) => row.id).sort(), ['a-complete']);Ce résultat attendu vient du besoin et des données d’essai. Il n’est pas calculé par la fonction d’export qu’on cherche justement à vérifier. La version volontairement incorrecte échoue alors au test.
C’est ce que je chercherais dans une proposition de vérification. De quelle information, exigence ou observation le vérificateur dispose-t-il pour pouvoir contredire l’implémentation? La réponse « une autre IA l’a relue » ne suffit pas à le préciser.
Un résultat utile, à condition de ne pas lui faire dire davantage
Le nouveau contrôle repère ce défaut dans ce jeu de données. C’est le constat.
Il ne prouve pas que tous les exports sont sécuritaires. La démonstration ne teste ni les requêtes HTTP, ni l’authentification, ni la création d’un fichier CSV, ni les liens de téléchargement, ni une base de données de production. Elle ne mesure pas la fiabilité d’un modèle. Un défaut repéré ne constitue pas un taux général de détection.
Il faut aussi distinguer le compte rendu de la preuve d’exécution. Lorsqu’une IA annonce que les tests ont réussi, elle rapporte un résultat. Pour le vérifier, il faut retrouver l’exécution, les contrôles réellement lancés, leurs résultats et la version examinée. Le fichier fourni avec cette expérience contient notamment l’empreinte du script et la version de Node utilisée.
Ces distinctions ne condamnent pas le développement automatisé. Elles lui donnent un rôle vérifiable : produire la modification, exécuter les contrôles, fournir les résultats et laisser une preuve contraire bloquer la mise en production.
Reproduire l’expérience
Le script autonome ne nécessite aucune dépendance et ne fait aucun appel réseau. Enregistrez-le sous le nom experiment.mjs, puis lancez :
node experiment.mjs
node experiment.mjs --json
Le résultat enregistré comprend les données fictives, les deux sorties, l’empreinte du fichier source et les limites de la démonstration. Le programme ne se termine avec succès que si la version correcte passe et si le contrôle supplémentaire rejette la version volontairement défectueuse.
Pour un vrai projet, je commencerais donc ailleurs que par le nombre de vérificateurs : quel résultat incorrect, mais plausible, ferait échouer nos contrôles actuels?
La réponse en dit davantage sur l’indépendance de la vérification que l’ajout d’un avis favorable. Le prochain article examine les droits d’accès réellement nécessaires à un agent de programmation.
Cet article vous a-t-il été utile?
Votre avis est transmis en privé à TechnoConception. Aucun compte ni courriel n’est demandé.
Comment votre avis est traité
Les réponses expirent après 90 jours. Elles ne sont ni publiées ni traitées comme des demandes commerciales. Un identifiant de réseau pseudonyme, renouvelé chaque jour, expire après 24 heures pour limiter les abus. Un nettoyage horaire supprime les données expirées. La base des avis ne conserve pas votre adresse IP; les journaux de sécurité de l’hébergement peuvent toutefois la traiter.
Ce navigateur conserve uniquement un reçu et votre évaluation jusqu’à l’expiration de la réponse pour limiter les doublons accidentels. Votre commentaire et la clé de modification ne sont pas conservés. Vous pouvez modifier une réponse tant que cette page reste ouverte; après votre départ, elle devient en lecture seule dans ce navigateur.
Politique de confidentialité